从整个网站作答
把整个网站或其中某一部分接到服务台。先读网站地图,由你挑定助手可读的版块,之后每晚或每周自动刷新。
答案多半早就写好了,就在你自己的网站上。整个网站 是服务台知识库的一条入口,把这些现成的答案调动起来,一个页面都不用手工复制。你把服务台指向一个站点,它读完网站地图,把那里有什么摆给你看,然后停下来等你挑出它可以读的版块。此后,它自己跟着站点走。
开始之前
你得先有一个建好的服务台,并且在它所属的品牌上有编辑者或更高权限。参见 创建并设置服务台。服务台上着线还是关着都行:接一个网站,两边都不受影响。
服务台只从自己的知识库作答,绝不碰公开网络(参见 客户服务概览)。填满这个知识库有五条路,这是其中一条,另外四条见 搭建知识库。材料已经发表在外、而且还在不断更新,就走这一条。只有一个页面,网页 更省事。文件从不离开自家系统,那就接一个素材库文件夹。
一步一步来
- 打开服务台,点 知识 方块,或者在地址后面加上 #knowledge。
- 在 知识库 卡片上选 整个网站。
- 核对 网站 里的地址。品牌自带站点的话,它已经替你填好。
- 点 检查网站地图。状态行写着“正在读取 robots.txt 和网站地图……尚未抓取任何页面。”这一步不计费。
- 把不想要的版块取消勾选。
- 点方案底部那个按钮。一个都没勾时它写着 读取页面,勾上之后它数出你挑的数量:读取 412 个页面。
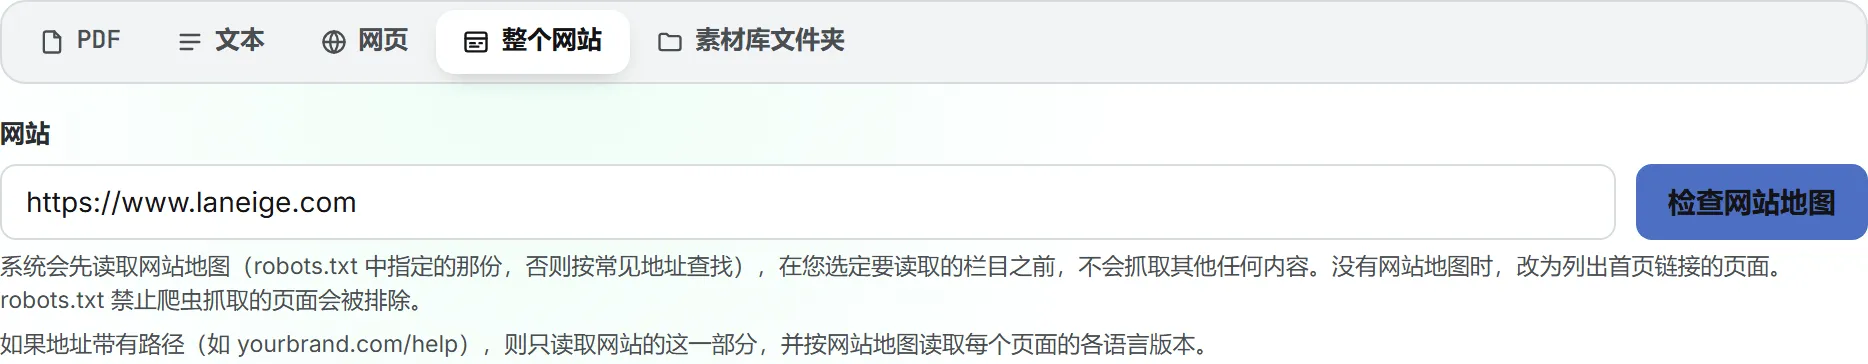
地址决定服务台接手站点的多大一块。只填域名 yourbrand.com,整个站点都摆上桌面,下一步再挑版块。填带路径的地址,比如 yourbrand.com/help,服务台就只读站点的这一部分:这个路径下的页面,外加网站地图为每个页面标出的各语言版本,不管它们放在站点的哪个位置(比如帮助页面的法语版 yourbrand.com/fr/aide)。帮助中心若是嵌在一个更大的站点里,就用这个办法把服务台指向它。
读取分批进行,状态行一批批报数:“example.com:正在读取页面,已完成 75/412……”。站点大的话要等上几分钟。你可以离开这个页面,已经索引好的照样算数。
读完之后,助手就像对待任何文档一样从这些页面作答,答案下面那行 “Sources:” 点名它出自哪个页面。客户读到的是你自己的措辞,外加一个链接,回到你写下它的地方。
这次检查告诉你什么
检查从 robots.txt 起步,既为它点名的网站地图,也为它定下的规矩。那里什么都没写,就去试几个常见地址。站点根本没有网站地图,检查转而退回首页链接到的那些页面;如果关联的是站点的某一部分,则退回这一部分自己的页面所链接的页面。卡片会告诉你事情就是这么发生的。
方案卡片开头是 已找到网站地图:,后面跟着网站地图的地址,做成链接;来自 robots.txt 的,后面再缀一句“(named by robots.txt)”。下面一行 已排除: 把清单还没露面就被丢开的那些算给你看:robots.txt 对爬虫关闭的页面、不算页面的文件、指向别的站点的地址。再往下是 版块,一个版块一个勾选框,标题旁边配着 全选 和 全部取消。
一个版块就是页面地址的第一段,所以 /blog/ 是一个版块。挂在根下的页面归到 一级页面。每一行给出页面数和几个地址样本,通常足够你不打开站点就分得清产品页和新闻稿。
清单底下是总数:“已勾选 412/980 个页面。”,后面提醒一句,索引按普通文档计费。
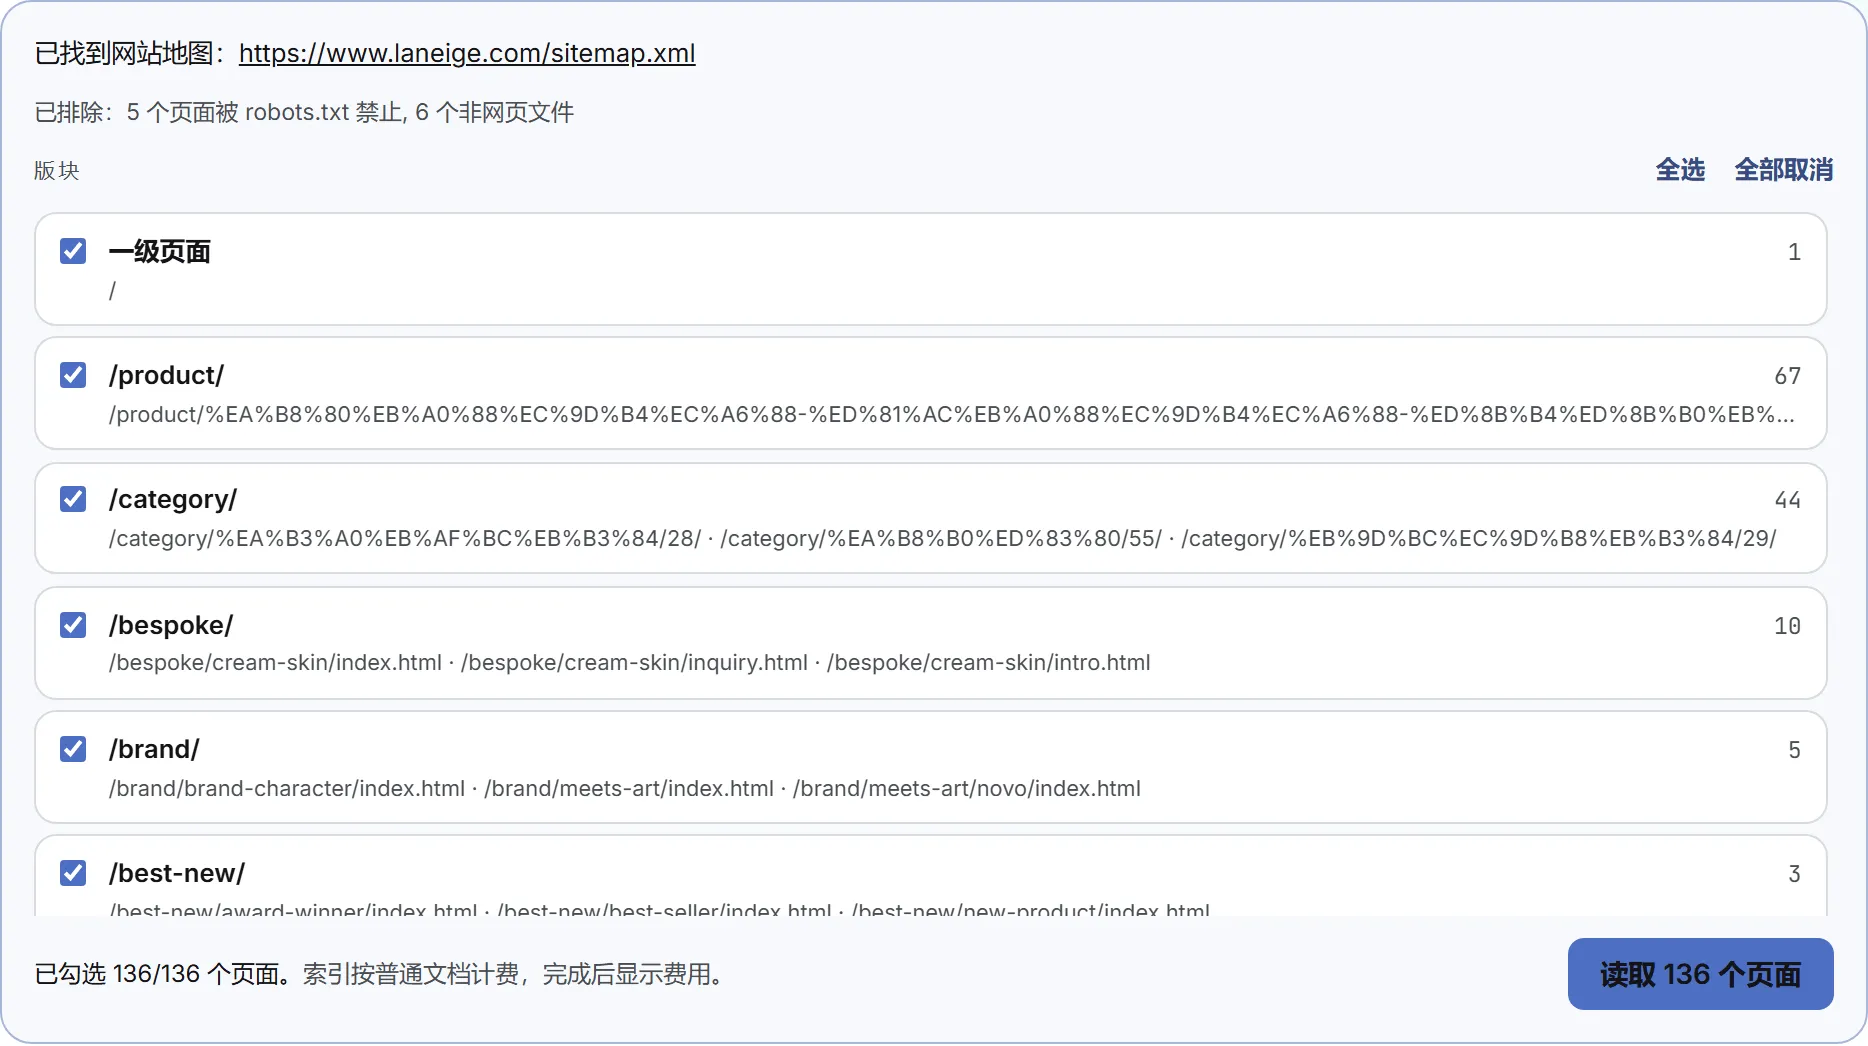
注意: 一个服务台每个网站最多读 1,000 个页面。超出这个数,总数会转红,按钮一直卡住,直到你取消足够多的版块。
什么会被读,什么不会
只有同一个站点的页面留得下。图片、视频、压缩包、样式表、脚本、Word 文件和电子表格都算文件而不算页面,一概跳过。网站地图里列出的 PDF 会被读。
页面内部只索引正文。菜单、页脚、侧栏和表单都被丢开,所以助手绝不会拿你的导航去回答问题。每个页面连同标题和地址一起存下,答案也正是靠这个把客户送回它出处的那一页。
几乎没有文字的页面跳过,地址旁边注明“该页面没有可读取的文本”。超过 5 MB 的页面同样跳过,跳转超过六次才到头的页面也一样。
读取的节奏经过控制,不会把你的服务器压垮。页面 25 个一批,同时跑五个,每个请求 20 秒不回就放手。自动重读先处理新页面和网站地图标为有改动的页面,再逐一询问其余页面自上次读取后是否有变动。没变的页面只回一句没变,不重发内容,也不花钱;有变动的页面会重读,所以即使网站地图上的日期没动,改动也照样能被发现。
已关联的网站列表
站点一接上,就在 已关联的网站 下面得到一行,位置在已关联的素材库文件夹上方。这一行先写主机名,如果关联的是站点的某一部分,后面再跟上路径,然后是一行小字,告诉你它现在什么状况:
| 你看到什么 | 它是什么意思 |
|---|---|
| “980 个页面中的 412 个” | 网站地图列出的页面里,已经索引了多少 |
| “读取于 [日期]”或“尚未全部读取” | 上一次跑完是什么时候 |
| “网站地图”或“无网站地图,取自首页链接” | 页面清单从哪里来 |
| “不含 /blog/、一级页面” | 你没挑的那些版块 |
| “14 个新增,3 个已更改,2 个已消失” | 等着下一次读取 |
| “2 个无法读取,下次同步时重试” | 失败的页面 |
右边一个标签,写着 已是最新、有待读取的页面 或 读取中。
一个网站的页面不在下面的文档清单里,头一回总有人意外。它们会把那份清单淹掉,一个站点动辄几百行。它们另有去处,收在自己网站那一行的 显示全部 [n] 个页面 下面。
再说这一行上的几个控件。重新读取: 是个下拉列表,有三个选项:每晚一次(新关联的网站默认如此)、每周一次 和 仅在我点击“立即同步”时。一选即存,改变的是下一次自动重读,当下并不读取。选择栏目 重新打开那份勾选清单,保存并读取 当场生效;取消勾选的版块,也正是靠这次保存把它的页面撤出知识库。显示全部 [n] 个页面 摊开这个站点贡献的一切,每个页面都可以点出去,各自带着片段数,或者失败的原因。立即同步 重读一遍网站地图,再读有改动的页面。取消关联 排在最后,标红。
自动重读
第一次读取就是这么回事。真正有意思的是之后:网站是唯一一个自己还在动的知识来源。
接上的网站会自动重读,节奏取决于它那一行上的 重新读取::
| 选项 | 何时运行 |
|---|---|
| 每晚一次 | 每天一次,在上一次自动读取超过 20 小时后进行。 |
| 每周一次 | 每周一次,在上一次自动读取满一周后进行,适合不常改动的站点。 |
| 仅在我点击“立即同步”时 | 从不自动运行。 |
每次自动重读都会按上文所说逐页检查整个站点,只重读有变动的部分。只有变过的东西才要钱:没动过的页面,或者文字跟上次一字不差的页面,一律放下不管,所以一个定型的站点即使每晚重读,也几乎不花钱。天天更新的站点,则天天花掉一点。
自动重读很安静,不在 动态 面板里开任务,也不发邮件。最近一次跑得怎样,看网站那一行:最近一次夜间读取:,或者每周重读的站点上的 最近一次每周读取:,后面写着上一趟的日期和花费,币种为你所在组织的币种(页面都没变时不标价格)。万一失败,这一行变红,日期换成错误信息,后面仍标着中断前已读内容的费用。下一次成功之后,日期回到原位。
特别大的站点要跑好几趟才读完,不会一趟到头。每一趟给一个网站两三分钟,然后就去下一个。参见 哪些事自己会跑。
取消关联一个网站
在那一行上点 取消关联。确认框写明:这些页面离开服务台的知识库,助手立刻不再拿它们作答。网站本身分毫未动,会话日志也一样,已经给出的答案保持原来的措辞。这一步没有回头路。再把这个站点接回来,每个页面都要从头读一遍,这笔读取费用你要再付一次。
服务台换到别的品牌
服务台可以在设置里换到另一个品牌。它接着的网站跟着走,文档和会话也跟着走。什么都不用重读,什么都不会丢。参见 创建并设置服务台。
限制一览
| 限制 | 数值 |
|---|---|
| 每个网站的页面数 | 1,000 |
| 单个页面大小 | 5 MB |
| 单个页面保留的文字 | 800,000 个字符 |
| 跟随的跳转次数 | 6 |
谁能做这些
| 操作 | 谁 |
|---|---|
| 查看已关联的网站和它们的页面 | 凡是打得开这个服务台的人 |
| 接入网站、同步、改版块、取消关联 | 服务台所属品牌上的编辑者或更高权限 |
组织里凡是角色能查看客户服务的人,都打得开这个服务台。参见 品牌 与 角色与权限。
版块宁少勿多
只接客户真正会问到的版块,别把整个站点端上去。一屋子新闻稿、十年份的博客,只会让答案更含糊,因为与问题匹配的段落是从服务台手里的全部内容里捞出来的。起步就窄一点。选择栏目 随时让你放宽,而放宽的代价,远低于把一个站点读两遍。
一趟读完,到 服务台 那一步的测试手机上问一个新页面应该答得出的问题。想知道自己接的是不是站点里对的那一块,这是最快的办法。
费用
索引一个页面就是一次 AI 调用,价钱跟你加进去的任何文档一样。检查网站地图不花钱。文字没变过的页面,重读也不花钱。
一趟跑完,费用出现在状态行里:“example.com:已索引 412 个页面,0 个未变,0 个已移除。”,后面跟着金额。动手之前没有报价,因为价钱跟着页面装了多少文字走,而这件事只有页面自己知道。
你还是估得出来。挑一个小版块,读一遍,看状态行报出的费用。用它乘以其余版块的页面数,就得到一个足够拿来拍板的数字。每一趟也都在你的 用量记录 里留下一行,所以第一个接进来的站点,大体就告诉了你下一个要花多少。
自动重读从品牌自己的额度里扣,并受这个品牌的支出上限约束。最近一次花了多少,标在网站那一行的 最近一次夜间读取: 或 最近一次每周读取: 旁边。参见 额度与费用 与 会话与费用。
排查
“该地址不是公开网站。” 这个地址解析到了一个内网。服务台只读公共互联网到得了的站点。
“[host] 上未找到网站地图,其首页也没有链接到本站的任何页面。” 这个站点既没有网站地图,也没有检查能顺着走的链接。改用 网页 一个一个加。
“[host] 的网站地图中没有可读取的页面。” 网站地图里只有文件,或者只有别的站点上的地址。用 网页 把你要的页面加进去。
方案里少了一些页面。 robots.txt 对爬虫关掉了它们,而检查尊重这条规矩。已排除: 那一行写着少了多少。你要是觉得不对,打开站点的 robots.txt 看看。
“共 [n] 个页面:请取消部分栏目,保持在 1000 个以内。” 把版块收窄。客户真正会问的那几块,读它们就够。
“所有栏目均未勾选:请至少勾选一个。” 保存之前先勾上点什么。
“该网站已关联到本服务台:请在其所在行点击‘立即同步’。” 它早就在清单上了。
有些页面老是读不出来。 返回 404 的页面以错误状态留在清单上,每次读取都再试一次,这样整趟活儿不会卡在它身上。地址确实作废了,修补的地方在站点这边:把它从网站地图里拿掉。
同一个页面答了两遍。 用 网页 加进来的页面,和作为网站一部分被读到的同一个页面,是两份文档。把你手工加的那份删掉。