选择模型:快速、均衡与旗舰
每个文本模型选择器都先给出快速、均衡、旗舰三个选项,各自标明所用模型和单次费用;想深究,就到模型基准测试页按公开得分比一比。
应用里的文本功能可以跑在三十多个 AI 模型上,但你不必记住任何一个名字。每个模型选择器都先给出三个简单选项:快速、均衡 和 旗舰,各自标明背后的模型和运行一次的费用。想弄清某个模型强在哪里,模型基准测试 页面会拿公开得分把它们摆在一起比。
模型按钮
运行文本功能的按钮旁边,有一个小巧的模型按钮。它显示你当前的选项、选项背后的模型名称,以及这项功能典型运行一次的费用,比如 均衡、一个模型名和一个价格。如果你选的模型不在这三个选项之中,按钮上就只显示这个模型和它的价格。
它出现在 Ask Intelligence、仪表盘生成器、品牌内容的文本表单(文案工作台、文章工作台、落地页内容简报和品牌基础表单)、社交媒体的帖子表单、搜索优化和广告投放的 AI 步骤、邮箱页面,以及选中一段文字后弹出的改写菜单里。
只有一个模型可用时,无从选择,也就没有按钮:表单上只写 运行于 加上模型名称。
快速、均衡与旗舰
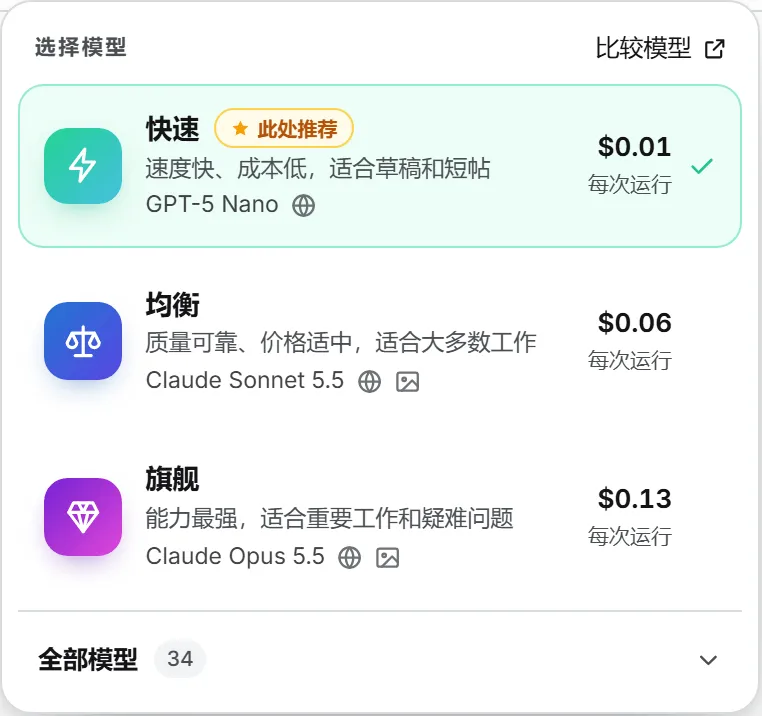
点一下按钮,打开 选择模型。最上面是三个选项:
| 选项 | 适合做什么 |
|---|---|
| 快速 | 速度快、成本低,适合草稿和短帖 |
| 均衡 | 质量可靠、价格适中,适合大多数工作 |
| 旗舰 | 能力最强,适合重要工作和疑难问题 |
每张卡片写明所用的模型:模型能联网搜索,就带一个小地球图标;能识别图片,就带一个图片图标。卡片还给出这项功能运行一次的价格,金额下方注着 每次运行。点一张卡片即可选用,弹出框随即关闭,按钮换成你的新选项。
“此处推荐”星标
其中一张卡片带着 此处推荐 星标,它装的是这项功能的默认模型,也就是管理员为这一页选定、没人挑选时就会运行的那个。默认模型总在三个选项之中:它会顶替价格与它最接近的那个选项。所以在默认模型擅长长文的页面上,星标可能落在 旗舰;在只写短配文的页面上,则可能落在 快速。
选星标卡片,等于“跟着默认走”:管理员日后换了默认模型,你的运行也随之切换。选其他卡片,或者从完整列表里挑一个模型,就是固定选用那个模型。
价格的含义
卡片上的价格,是这项功能典型运行一次的全包费用,也就是向你的组织收取的金额。功能不同,价格也不同:一篇长文章读进和写出的内容,远多于一条社交帖子。实际运行时,简报长就贵一些,简报短就便宜一些。运行结束后,确切金额显示在结果旁边,同时记入你的 用量记录。选择器从不显示每百万 token 的单价;运行如何付费,见 额度与费用。
全部模型
三张卡片下面,全部模型 可以展开完整列表,旁边标着模型数量。列表收录组织允许使用的全部模型,你在 我的模型 里关掉的除外。
- 模型按提供商分组,每个都标有运行一次的价格,以及同样的联网搜索和识图图标。
- 这项功能的默认模型带一个 默认 标记。
- 在 搜索模型或提供商 里输入几个字,就能缩小范围。一个都对不上时,列表显示 没有匹配的模型。
你当前用的模型不在三个选项之中时,列表会自动展开。在 Ask Intelligence 里打开 联网搜索 开关后,卡片和列表都只保留会联网搜索的模型,见 数据与联网搜索。
方向键在各个选项之间移动,回车确认,Esc 关闭弹出框且不做任何改动。Esc 只关这个弹出框,不会连带关掉外面那层窗口。
选择会被记住
选择器按功能记住你的选择,记在当前浏览器里。LinkedIn 帖子一律用 旗舰 写,你只需选一次。换一个浏览器或换一台设备,就又从默认模型起步。
同一页面上同一项功能出现不止一次时(比如每种帖子格式各有一张表单),它们都跟着你在任意一处做的选择走。你选的模型日后若被禁用或下架,选择器会忘掉它,回到默认模型;从一直开着的旧页面发出的运行会被拒绝并附上一句说明,选择器随即重新加载,不再列出那个模型。
选项所用的模型你用不了时
每个选项跑哪个模型,由管理员在 AI 模型 页面上决定(见 AI 模型管理)。选项不会因为模型够不着就消失。如果这个模型在你的组织里被禁用,或者你在 我的模型 里把它关掉了,这个选项就改用你能用的模型中价格最接近的那个。快速 先往更便宜的方向找,旗舰 先往更强的方向找,因此快速始终省钱,旗舰始终够强。
两张卡片绝不会显示同一个模型。可用模型只有一两个时,你看到的卡片也只有一两张。
模型基准测试
模型基准测试 页面展示各文本模型在独立公开基准测试中的表现,以及每个模型典型运行一次的费用。入口有三个:
- 每个选择器顶部的 比较模型。它在新标签页里打开页面,你的表单原样保留。
- 设置中 我的模型 卡片上的 通过公开基准测试比较模型。
- AI 模型 页面上的同一个链接,供管理员使用。
三个选项
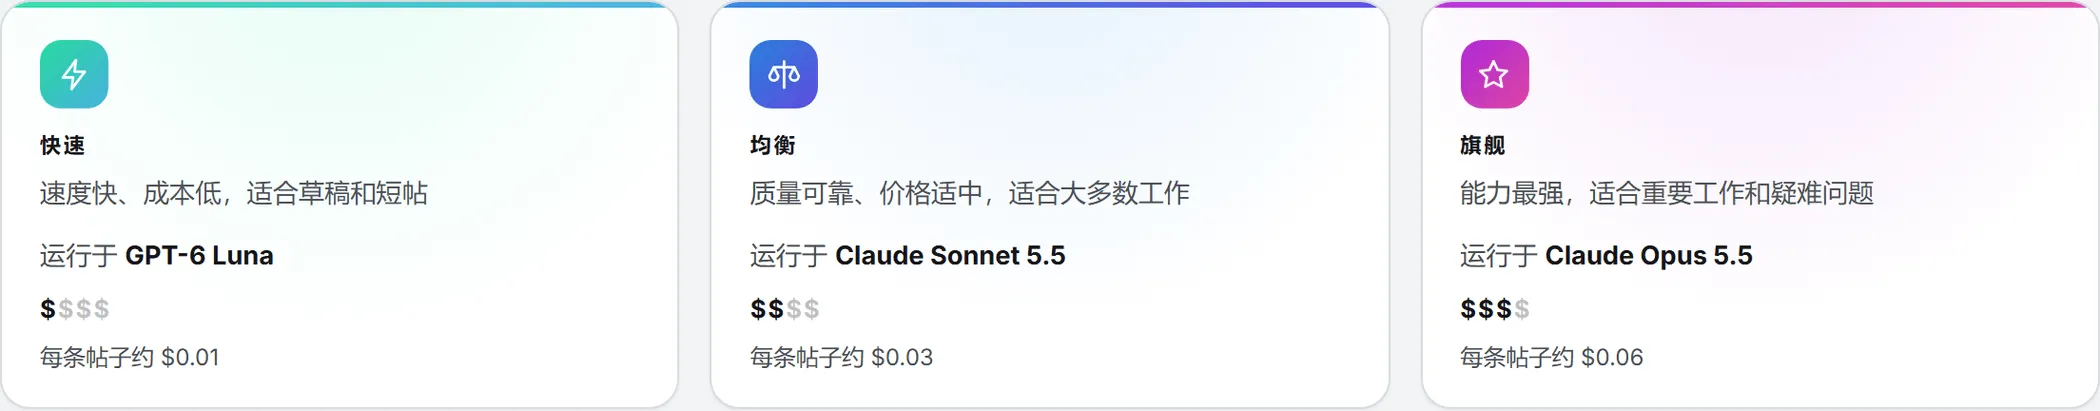
页面开头是三张卡片:快速、均衡 和 旗舰。每张在 运行于 后面写明它在你的组织里所用的模型,给出从 $ 到 $$$$ 的价格档位,并标出用它写一条 LinkedIn 帖子大约花多少。价格档位只说明一个模型和其他模型相比贵不贵,从不给出具体金额。某个选项已经没有模型可用时,卡片显示 此处不可用。
得分与费用
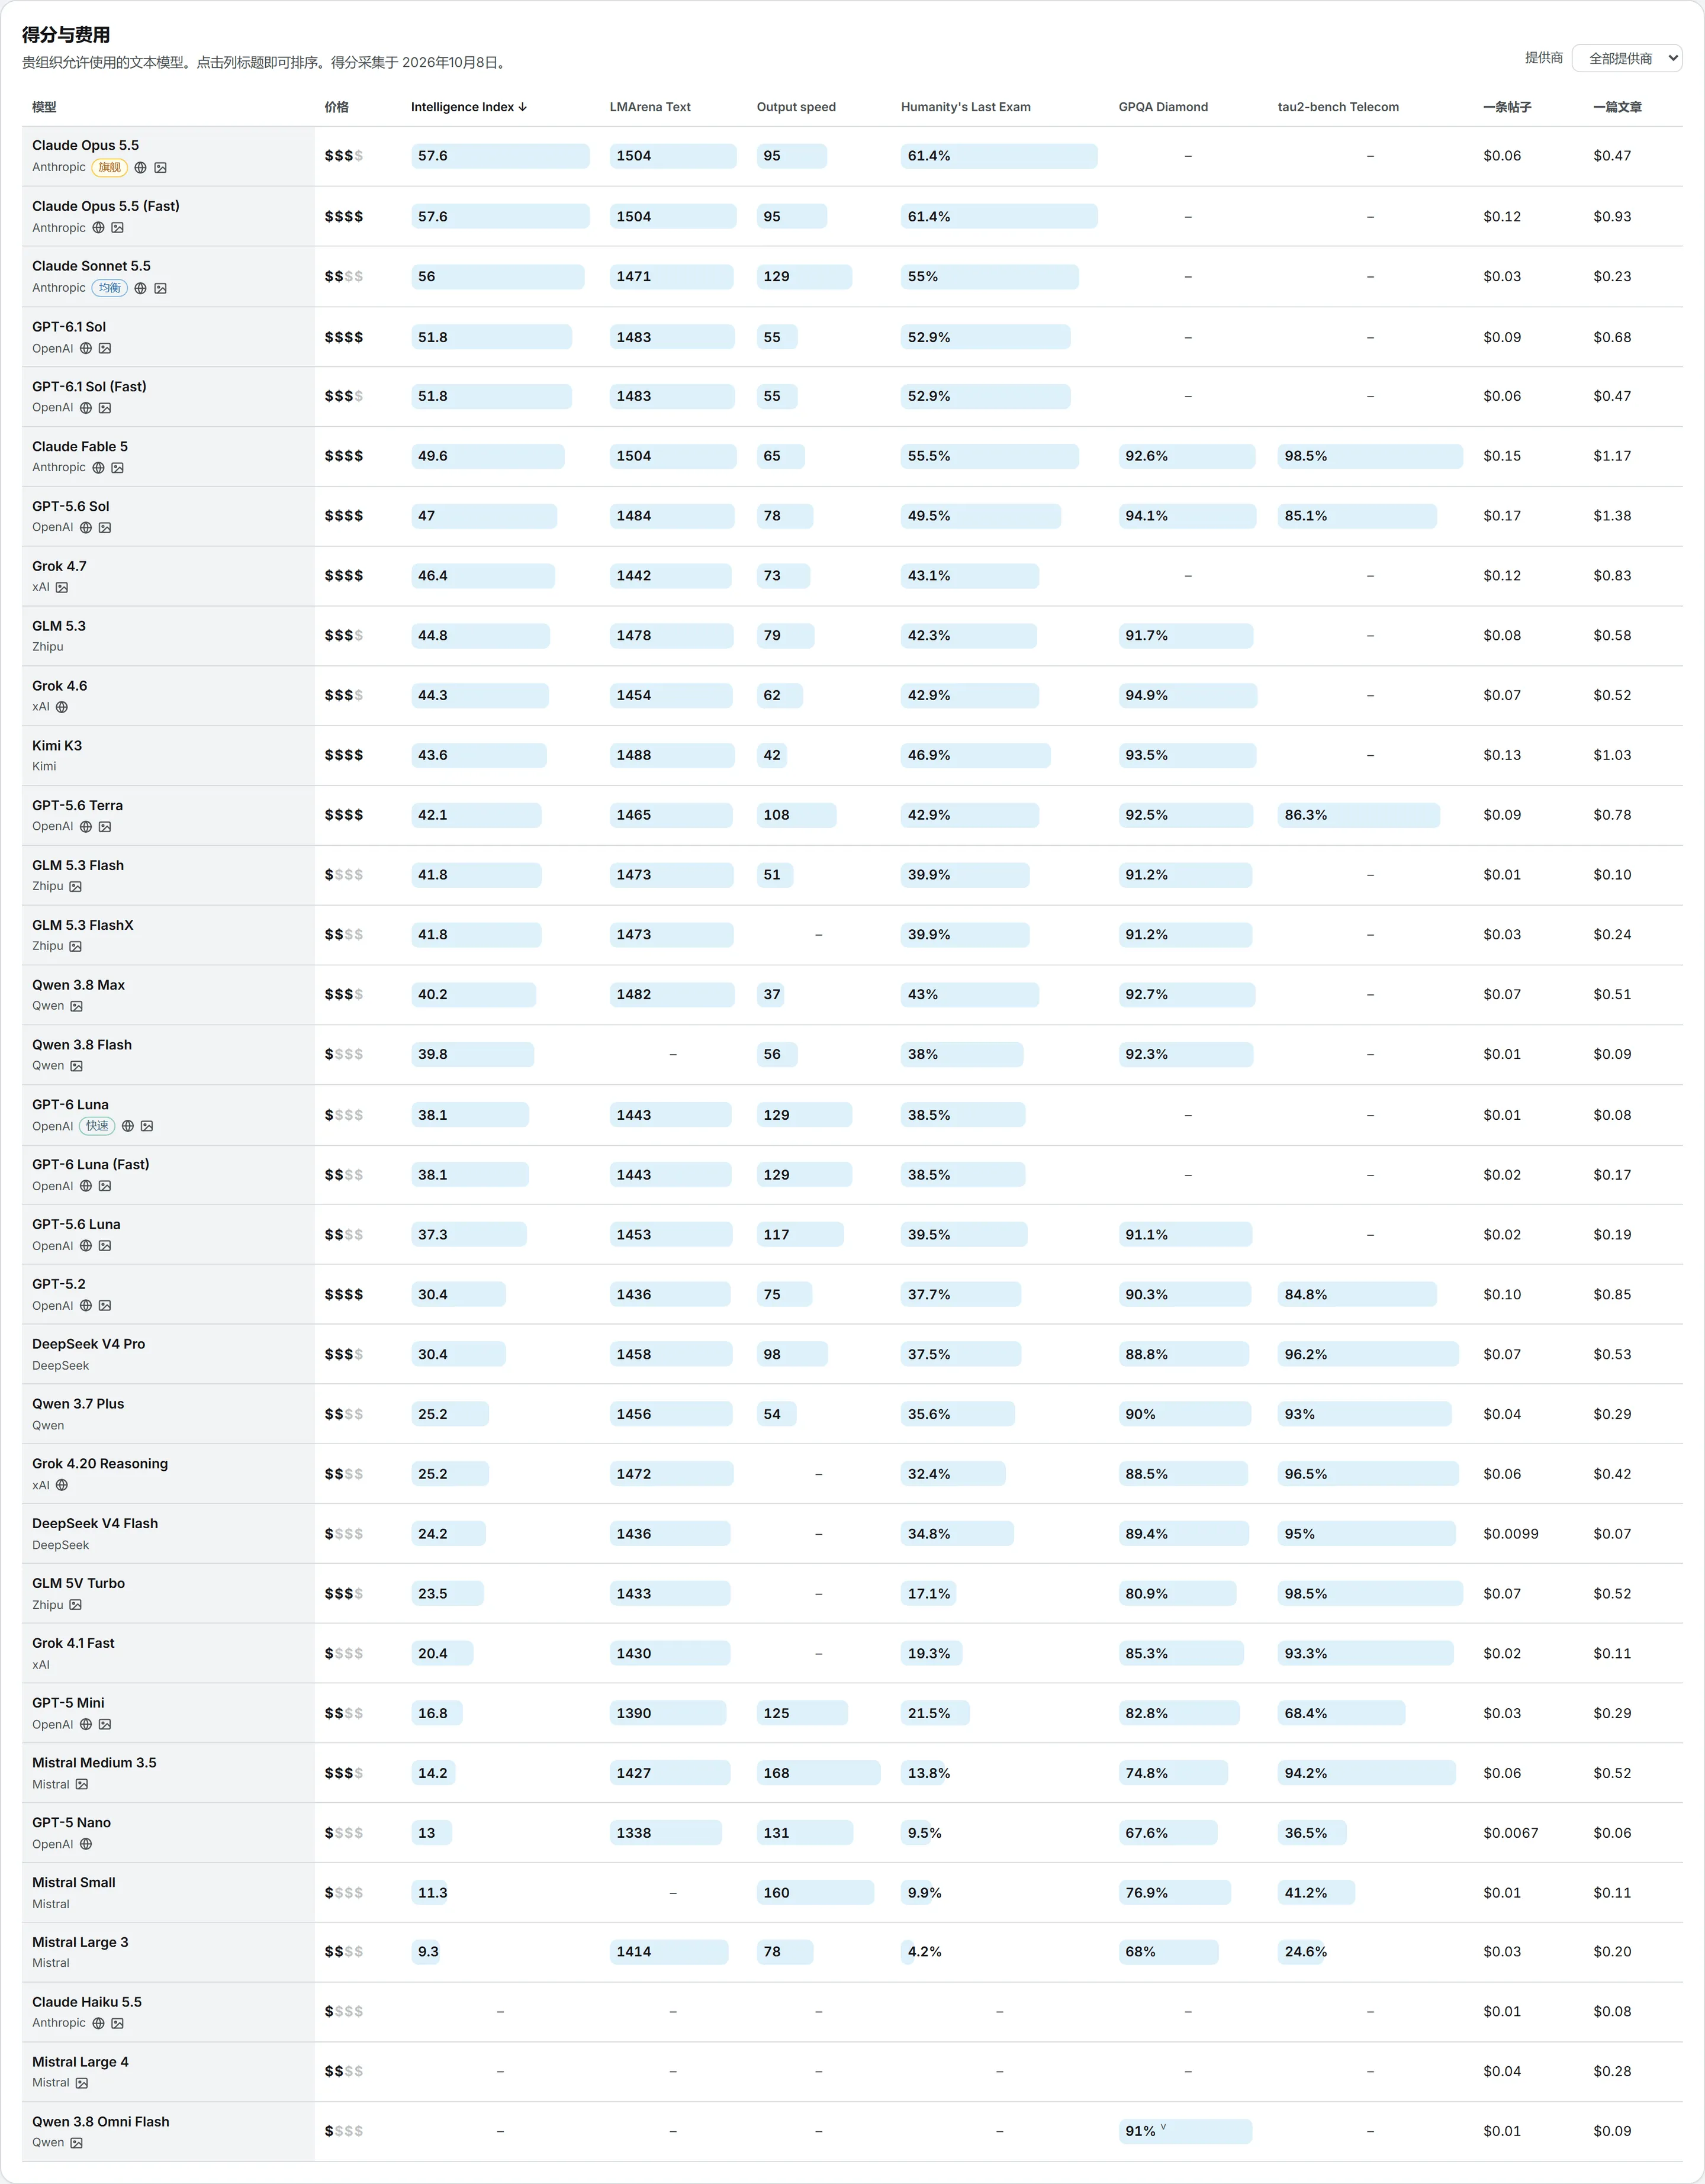
得分与费用 卡片列出组织允许使用的文本模型,按 Intelligence Index 从强到弱排列。
页面顶部的 图片 和 视频 标签页以同样方式列出图片和视频引擎,附上各自的竞技场评分,以及按默认质量生成一张图片、或生成一段 8 秒无声短片的费用。用于放大视频的引擎 Proteus 和 Starlight Precise 2.6 也列在 视频 标签页中,并标注 视频放大。它们没有基准得分,费用按一段 24 帧/秒、时长 8 秒的视频放大至 1080p 计算。视频页面上的 放大片段 会在开始前显示您所选视频的准确价格。
| 列 | 内容 |
|---|---|
| 模型 | 模型名称和提供商,并标出它承担的选项、可联网搜索 和 可识别图片 |
| 价格 | 价格档位,从 $ 到 $$$$ |
| Intelligence Index | Artificial Analysis 的综合得分,汇总推理、知识、编程和智能体任务等九项高难度测试 |
| LMArena Text | 由盲测投票得出的评分:两份回答摆在面前,由人选出更好的一份 |
| Output speed | 模型开始作答后,每秒写出多少 token |
| Humanity’s Last Exam | 约 2000 道极难的专家级题目,最强的模型得分也远低于 100% |
| GPQA Diamond | 研究生水平的科学题,即便联网搜索也很难答对 |
| tau2-bench Telecom | 一段客服对话,模型必须正确调用工具并遵守规则 |
| 一条帖子 | 一条 LinkedIn 帖子,全包费用 |
| 一篇文章 | 一篇长文章,全包费用 |
点列标题即可按该列排序:得分从强到弱,价格档位和费用从低到高,再点一次则顺序颠倒。某一列没有数据的模型,始终排在最后。用 提供商 可以只看某一家厂商的模型,选 全部提供商 即恢复全部。
怎么读这些数字
- 每个得分都是链接,指向采集这一数据的公开页面。
- 得分旁的小写“v”,表示数据出自模型厂商自己的发布文章,只在没有独立数据时采用。
- 短横线 表示该模型没有公开数据。得分从不估算。
- 采集日期 写在卡片标题下方。得分每月更新两次。
最后一张卡片 各项基准测试衡量什么,逐项介绍每个测试,并链接到出处。某项测试得分高,不代表模型样样都强。写营销文案,先看综合指数和 LMArena,后者由人们投票选出更喜欢的回答。
提示: 基准测试用的是别人的问题。想看两三个模型怎么处理你自己的素材,就在 试验场 用 对比 把同一条提示词发给它们,每个回答各自标价。
谁能做什么
| 动作 | 谁 |
|---|---|
| 运行功能时选一个选项或一个模型 | 有权运行该功能的人 |
| 打开模型基准测试 | 每个有账户的人 |
| 从自己的选择器里隐去模型 | 每个人,在 我的模型 里 |
| 设定快速、均衡与旗舰所用的模型 | 管理员,仅限本组织 |
| 设定页面的默认模型,也就是带星标的那个 | 管理员,仅限本组织 |
打开选择器或基准测试页面不花钱。运行按实际跑起来的模型计费。