对话
为两到四位说话人各选一个声音,自己写台词或由文本生成,再把整段对话录成一条音频。
对话 把两到四个声音录成一段对话。声音之间轮流发言、相互回应、有呼吸停顿,就像真人聊天,而不是把单独录好的片段拼在一起。
语言与说话人
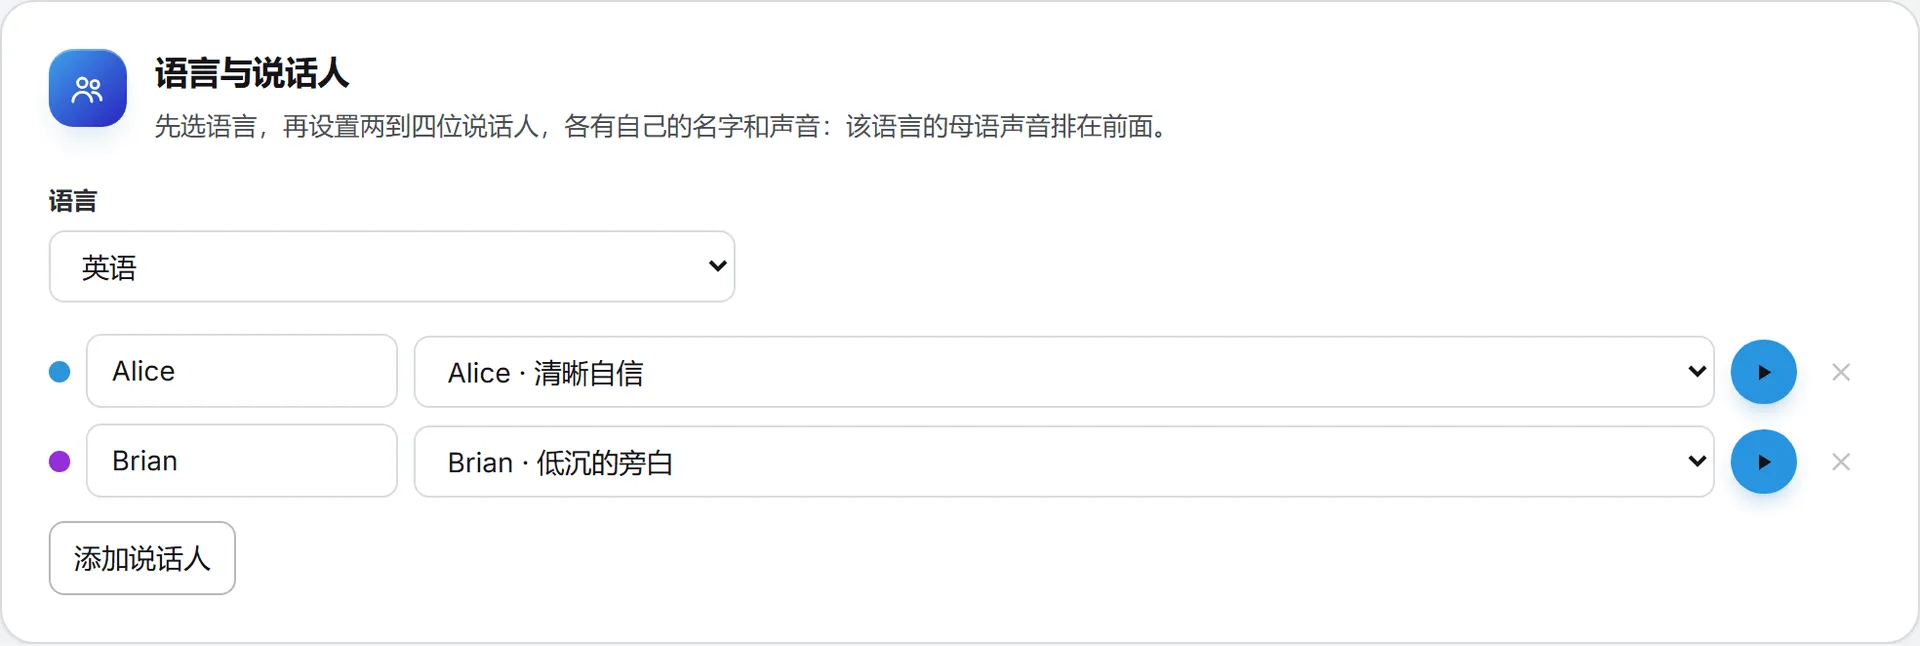
先选 语言:默认是英语,列表涵盖多人语音模型能说的所有语言。再为每位说话人设置名字和声音。每位说话人的声音列表先列出该语言的 母语声音,再列出 带口音 的声音,也就是以英语为母语、说任何语言都带着自己口音的标准声音。声音旁的播放按钮会用所选语言试听。切换语言时,如果有同性别的母语声音,每位说话人都会自动换成它。添加说话人 可再加第三、第四位。删除某位说话人后,其台词会交给第一位说话人。
改写成对话
用现有内容生成台词:
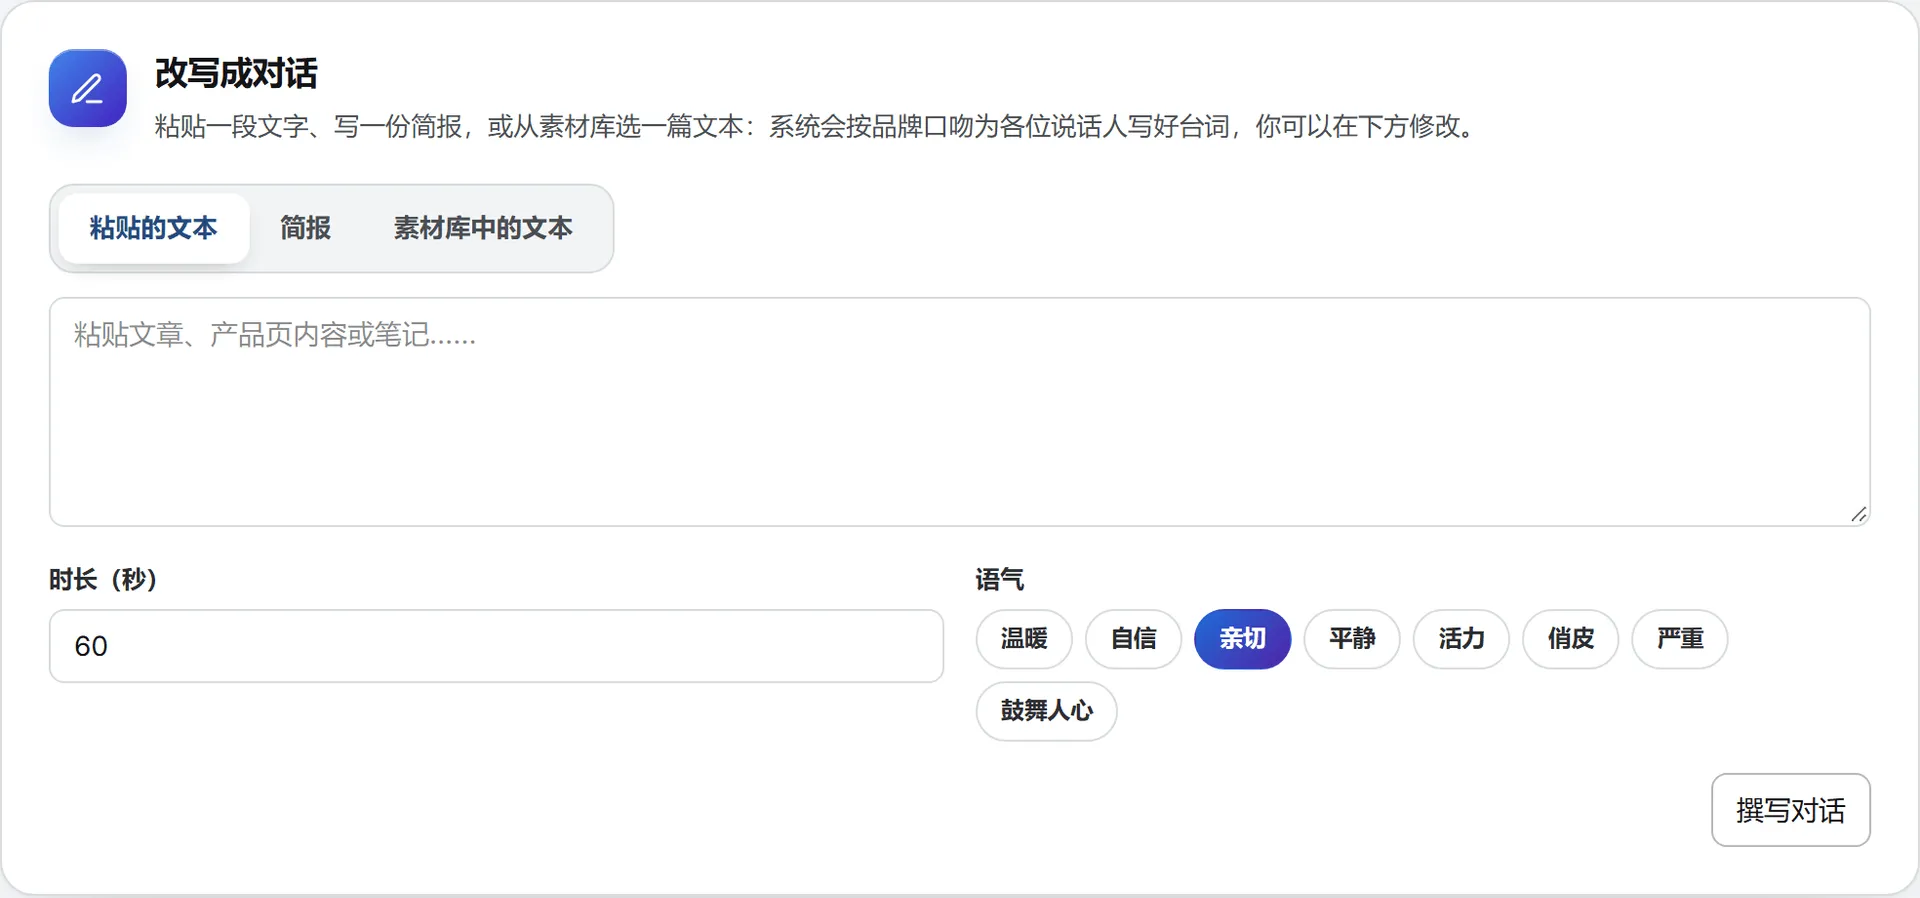
- 粘贴的文本:文章、产品页内容、笔记。
- 简报:对话的主题,以及谁说什么。
- 素材库中的文本:素材库里的文档(文本、Word、PDF),通过 选择文本 选取。
填写时长(秒)并选择语气,然后点击 撰写对话。系统会按品牌口吻为各位说话人写好台词,并替换下方的列表。价格显示在结果旁边。
台词
每轮发言一行。每行都有说话人、台词内容,以及上移、下移和删除按钮。添加台词 会为下一位说话人新增一行。列表下方会统计字符数、估算时长并显示价格。
模型
这里只提供能在一条音频中录制多个声音、且能说所选语言的模型:Eleven v4 和 Eleven v3,默认选中较便宜的一个。右上角选定的品牌会根据其 品牌声音套件 带入语言、模型和第一位说话人的声音,并把发音规则套用到每一句台词。
生成
点击 生成对话。较长的对话会在台词之间分段录制,再合成一条音频,最多 10,000 个字符。生成的音频会出现在按钮下方,附带播放器和价格,也会出现在 历史记录 中。